Od kilku lat można zaobserwować rosnącą popularność organizacji opartej na danych (ang. data-driven organization). Jednak doświadczenia wielu firm wskazują, że transformacja organizacji do standardu data-driven nie jest tak łatwa, jak sugerują slogany szkoleniowe i marketingowe.
Obecnie w typowej dużej organizacji problem braku czy niedostępności danych już nie występuje. Zamiast tego mamy do czynienia z nadmiarem danych, co niestety często skutkuje:
- trudnościami z dotarciem do odpowiednich danych,
- brakiem wiarygodnych danych,
- niespójnością analiz,
- błędnymi lub spóźnionymi wnioskami.
W artykule omówię podstawowe przyczyny opisywanego zjawiska oraz wskażę typowe problemy, z którymi spotkałem się w ostatnich latach pracy. W ostatniej części przedstawię wskazówki dotyczące właściwego podejścia do danych dla osób zajmujących się ich gromadzeniem i analizą. Purystów i teoretyków uprzedzam, że nie opisuję sytuacji wzorcowych, lecz realne, „z życia wzięte” przypadki, które nie zawsze mieszczą się w ramach teorii, standardów czy budżetów.
Poniższy materiał stanowi głos w dyskusji na temat rekomendowanych kierunków rozwoju systemów ETL (ang. Extract, Transform, Load) i analizy danych. W kolejnych publikacjach przedstawię bardziej techniczne podejście do tego zagadnienia.
Spojrzenie na historię analizy danych
Nieco upraszczając, można przyjąć, że historia korporacyjnych systemów analizy danych rozpoczęła się w latach 80. wraz z kanonicznymi pracami Billa Inmona, ojca koncepcji hurtowni danych. Podejście Inmona kładło nacisk na:
- gromadzenie danych w modelu biznesowym, ukierunkowanym na potrzeby analityczne organizacji,
- niezmienność zgromadzonych danych w czasie,
- przechowywanie tylko danych poprawnych (o wysokiej i zweryfikowanej jakości),
- jedno źródło danych dla wszystkich potrzeb analitycznych.
Koncepcja ta sprawdzała się bardzo dobrze w organizacjach o dobrze określonych potrzebach i oczekiwaniach, działających w stosunkowo wolno zmieniającym się otoczeniu biznesowym.
Mankamenty oryginalnej koncepcji Billa Inmona, takie jak:
- długi proces developmentu,
- skomplikowany sposób wprowadzania zmian i rozwoju,
- wysokie koszty utrzymania,
ujawniły się wraz ze znacznym wzrostem tempa zmian w środowisku biznesowym, spowodowanym przenoszeniem procesów wirtualnych.
Jak zrodziła się koncepcja data lake?
Potrzeba biznesowa posiadania danych „szybko i tanio” zrodziła wiele nowych koncepcji magazynowania danych, w tym jedną zwaną „data lake”. Surowe dane, uzupełnione przez narzędzia analizy ad hoc (Tableau, Power BI i inne), pozwalają analitykom na pracę z danymi natychmiast po ich pozyskaniu. Tym samym analityk nie ma już dostępu do ujednoliconych i zweryfikowanych danych, ale dysponuje całym spektrum danych i analiz z różnych źródeł, o nieznanej strukturze i nie zawsze sprawdzonej wiarygodności.
Sytuacja ta często skutkuje nieoczekiwanymi wynikami. Poniżej przedstawię kilka przykładów z życia oraz omówię przyczyny pojawiających się niezgodności.
Przykład 1 – analiza liczby logowań do Bankowości Internetowej danego dnia
- Google Analytics: 52,763
- Log aplikacyjny: 47,391
- Analiza przyczyny niezgodności: ta sama nazwa miary „liczba logowań” nie zawsze oznacza to samo w każdym systemie. We wskazanym przykładzie błędnie użyto nazwy „liczba logowań” do opisu zdarzenia polegającego na wejściu na stronę logowania, w tym logowania udane, błędne i porzucone. W drugim źródle pod identyczną nazwą były zliczane wyłącznie logowania zakończone sukcesem.
Przykład 2 – niestatystyczne dane: dzienna liczba operacji typu „przelew własny”
- Wartości danych w pewnym zakresie dat znacząco odbiegają od średniej dla danej kategorii w danym dniu tygodnia.
- Analiza przyczyny niezgodności: niewykryta awaria komponentu komunikacyjnego odpowiedzialnego za transfer danych z systemu pomocniczego. W konsekwencji, z powodu braku walidacji po stronie ETL, brak jednego komponentu (atrybutu) nie spowodował wygenerowania błędu ani ostrzeżenia, lecz doprowadził do stworzenia niepoprawnego raportu – część operacji została błędnie zakwalifikowana do innej kategorii.
Przykład 3 – niestatystyczne dane: dzienna liczba transakcji w urządzeniu ATM
- Wartości danych w pewnym zakresie dat wynoszą 0.
- Analiza przyczyny niezgodności: pierwsze podejrzenie wskazywało na awarię urządzenia ATM i brak operacji. Automatyczny system monitorowania nie wykazał jednak awarii technicznej, co wymagało przeprowadzenia serwisu fizycznego urządzenia. Serwisant, po przybyciu na miejsce, zgłosił, że ekran i klawiatura urządzenia zostały pomalowane farbą w sprayu, co uniemożliwiło dostęp do urządzenia.
Powyższe przykłady wskazują, że analityk powinien zwracać szczególną uwagę na jakość i wiarygodność uzyskanych wyników analiz lub raportów. Nadmierne zaufanie do danych może prowadzić na ślepy tor.
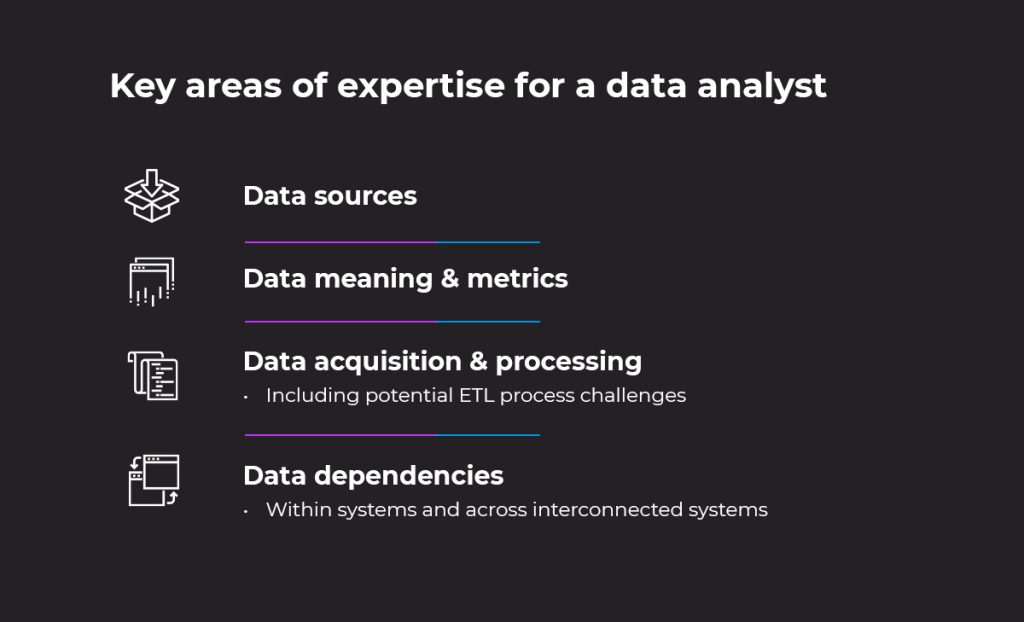
Jaką wiedzę musi posiadać analityk danych?
Analityk powinien posiadać wiedzę na temat:
- źródła danych,
- znaczenia danych oraz stosowanych miar,
- pozyskiwania i przetwarzania danych, a także potencjalnych problemów w procesach ETL,
- zależności pomiędzy danymi zarówno wewnątrz systemu, jak i w odniesieniu do innych systemów.
Co jest niezbędne do uzyskania wiarygodnych wyników analiz?
Aby uzyskać wiarygodne wyniki analiz, niezbędne jest:
- określenie zasad walidacji kompletności i spójności danych,
- zweryfikowanie procesów ETL związanych z danymi,
- walidacja samej analizy, w tym badanie właściwych danych oraz analiza wszystkich odrzucanych danych w procesie.
Podsumowanie – jak nie utonąć w jeziorze danych?
W rzeczywistości, choć dostęp do danych jest powszechny, to nadmiar informacji generuje problemy związane z ich jakością, spójnością i wiarygodnością. Aby uniknąć nieprawidłowych wniosków, konieczne jest wprowadzenie solidnych mechanizmów walidacji i kontroli jakości na każdym etapie analizy. Przypadki z życia organizacji jasno pokazują, że każda analiza danych wymaga głębokiego zrozumienia źródeł i metod ich przetwarzania.
Potrzebujesz wsparcia w przekształcaniu danych w wartość dla całej organizacji?
O autorze
Analityk biznesowy i techniczny z ponad 10-letnim doświadczeniem w branży IT, specjalizujący się w kierowaniu projektami, zarządzaniu projektami oraz doradztwie biznesowym. Współpracował z dużymi organizacjami z sektorów finansowego, medialnego i telekomunikacyjnego. Posiada umiejętności w zakresie usprawniania procesów biznesowych, wykorzystywania nowoczesnych strategii marketingowych opartych na analizie dużych zbiorów danych oraz pracy w ramach metodyki Scrum.